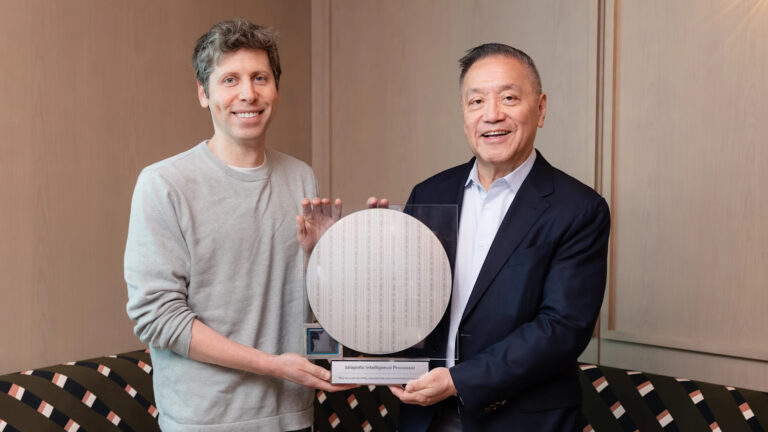
OpenAI y Broadcom presentaron este miércoles Jalapeño, el primer chip propio de OpenAI y el inicio de una plataforma de cómputo de múltiples generaciones que ambas compañías desarrollarán en conjunto.
El acelerador está diseñado desde cero para la inferencia de modelos de lenguaje de gran escala y será desplegado a escala de gigawatt con socios de centros de datos a partir de 2026.
Construido específicamente para inferencia de LLMs
A diferencia de los aceleradores de propósito general adaptados desde cargas de trabajo anteriores, Jalapeño fue construido específicamente para inferencia de LLMs, la etapa en que los modelos de IA generan respuestas para los usuarios.
Su arquitectura reduce el movimiento de datos y equilibra los recursos de cómputo, memoria y redes para lograr una utilización real más cercana al rendimiento teórico máximo del hardware.
En términos de costos, apuestan por una mayor eficiencia energética, lo que implica directamente menores costos operativos por consulta, lo que puede traducirse en respuestas más rápidas en ChatGPT, tareas más largas en Codex con menor tiempo de espera, y una API más barata para desarrolladores y empresas.
“Jalapeño es parte de nuestra estrategia de infraestructura de pila completa a largo plazo para hacer el cómputo más abundante, lo que resulta en una IA más rápida, más confiable, más asequible para personas y empresas”, señaló Greg Brockman, presidente y cofundador de OpenAI.
Nueve meses desde el diseño hasta la fabricación
El desarrollo del chip tomó solo nueve meses desde el diseño inicial hasta la fabricación, lo que OpenAI y Broadcom consideran el ciclo de desarrollo ASIC más rápido logrado en semiconductores avanzados de alto rendimiento.
Parte de esa velocidad se explica por el uso de los propios modelos de OpenAI para acelerar etapas del diseño y optimización del chip. Es decir, la misma IA que se sirve a los usuarios ayudó a construir la infraestructura que correrá los modelos futuros.
“Jalapeño fue diseñado desde cero para inferencia de LLMs usando información detallada de nuestra estrecha colaboración con los investigadores de OpenAI”, explicó Richard Ho, quien lidera el programa de hardware de la compañía.
“Optimizamos la arquitectura alrededor de los kernels, el movimiento de memoria, las redes y los patrones de servicio que más importan para los modelos de IA de frontera. Basándonos en las pruebas iniciales, Jalapeño ejecutará eficientemente nuestras cargas de trabajo más importantes cerca de los límites teóricos del hardware“, agregó.
Lo más leído
- Kast marca distancia de RN y descarta "piñerizar" la agenda laboral: "No se trata de ocupar la fórmula de uno u otro presidente"
- Balance por sistema frontal: Advierten que peak de lluvias será esta noche y reportan las primeras viviendas anegadas
- "Abre una caja de Pandora enorme”: La dura advertencia de Raúl Sohr sobre los conflictos bélicos en el futuro
- Subsecretario de Educación responde a exministro Cataldo y descarta “matar al SAE”: “Es un término bien desafortunado, nosotros le estamos haciendo modificaciones”
- Crimen de carabinero en Renca: Cae nuevo sospechoso y solo resta un prófugo tras siete detenciones